La méthode en 6 étapes pour produire du contenu sourcé, différencié et prêt à publier.
« Écris-moi un article de 1 500 mots sur X. »
Le LLM improvise avec sa mémoire d'entraînement. Contenu générique. Aucune source. Hallucinations.
On donne du contexte au LLM avant d'écrire. On décompose la rédaction en 6 étapes. On contrôle ce qui sort à chaque niveau.
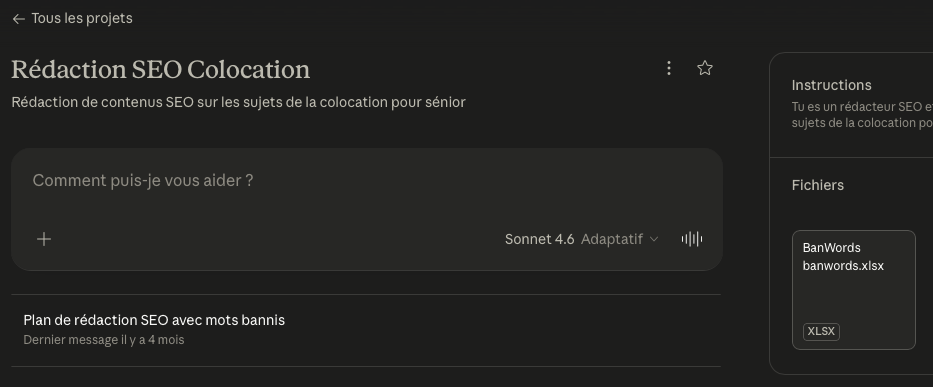
ChatGPT ou Claude Projects. On y stocke brief client, marché, concurrents, personas, banwords. Réutilisé pour tous les articles du client.
Contexte → Plan → Prompts → Rédaction → Médias → Assemblage. Chaque étape produit le livrable de la suivante.
Vous validez le plan, les angles, le ton. Le LLM est un rédacteur qui suit un brief détaillé.
Plus on est dans la conversation, plus c'est prioritaire.
Le LLM charge automatiquement tout ce que vous avez mis dans le Projet avant même que vous écriviez un seul mot.
10 premiers résultats pour le mot-clé cible. Extension Chrome Web Page Text Extractor.
Articles d'actualité sur le sujet. Informations fraîches, angle du moment.
Grammes 1, grammes 2, entités nommées. Liste sémantique complète.
// Le LLM analyse la SERP et les News // Il identifie les angles non couverts par les concurrents // Il répartit TOUS les mots-clés YTG dans les chapitres <request>comment tailler rosier</request> <keywords>mots-clés-YTG.txt</keywords> <competitors-plans>Analyse SERP + Google News</competitors-plans> // Output : JSON {titleSEO, title, chapters:[{title, prompt, keywords}]}
Pourquoi : vous validez la structure avant d'écrire. Si le plan n'est pas bon, l'article ne le sera pas.
Titres génériques. Chapitres qui se répètent. Angles absents. Aucune validation humaine. Structure dictée par le modèle, pas par la SERP.
Titres H2 optimisés. Angles différenciés. Chaque chapitre a son mot-clé. Vous validez en 30 secondes. Structure dictée par l'analyse SERP.
<topic> Titre SEO + Titre article + Mots-clés <title> Titre du chapitre + description contenu attendu <nbwords> Total mots ÷ nb chapitres <keywords> Mots-clés YTG attribués à ce chapitre <previous-chapter> + <next-chapter> pour la cohérence <banwords> + <infos-client>
Pourquoi : chaque prompt contient tout ce dont le LLM a besoin pour rédiger CE chapitre : sans déborder, sans improviser.
// Règles strictes de rédaction : // • Utiliser OBLIGATOIREMENT les documents du projet // • Extraire chiffres, dates, sources depuis le contexte // • Ne pas répéter le chapitre précédent // • Ne pas anticiper le chapitre suivant // • Pas d'intro ni de conclusion (le chapitre s'insère) // • Éviter ABSOLUMENT les banwords // • Output : HTML (<h3>,<h4>,<p>,<table>,<blockquote>)
Le chapitre sort en HTML propre, structuré. Pas de markdown, pas de nettoyage. Prêt à intégrer.
« Dans cet article, nous allons voir… »
« Il est important de noter que… »
« En conclusion… » / « De nos jours… »
Google et les lecteurs reconnaissent ce style.
Le LLM est forcé de trouver des alternatives. Résultat : un ton direct, sans tics de langage IA. Le lecteur ne voit pas la différence.
Le fichier banwords.csv est appliqué à chaque étape.
Un classifieur détermine le type de média optimal en fonction du contenu du chapitre, puis génère le prompt de création.
// 1. Tous les chapitres sont concaténés dans l'ordre. // On ne modifie JAMAIS le contenu des chapitres. // 2. Le LLM génère : → Title + TitleSEO (40-70 car.) → Meta-description (≤155 car.) → Introduction (~60 mots) → Conclusion H2 avec mot-clé (~60 mots)
L'intro et la conclusion sont générées à partir du contenu réel de l'article. Pas inventées. Cohérence totale.
Structuré, sémantique, avec meta-données SEO. Prêt à copier-coller dans WordPress.
Optimisés pour Google. Title 40-70 car., meta ≤155 car. avec mot-clé principal.
Photo, infographie ou widget. Format 16:9, optimisé web, unique pour cet article.
Le plan structuré peut être réutilisé pour des articles similaires ou décliné pour d'autres mots-clés.
ChatGPT ou Claude. Mettez brief client, marché, banwords dans le Projet. SERP, News et YTG en pièces jointes dans la conversation.
Prompt 1-plan.txt. Validez la structure et les angles avant de continuer.
Un prompt de rédaction par chapitre. Chaque chapitre a son brief.
Exécutez les prompts. Générez les médias. Assemblez. Publiez.
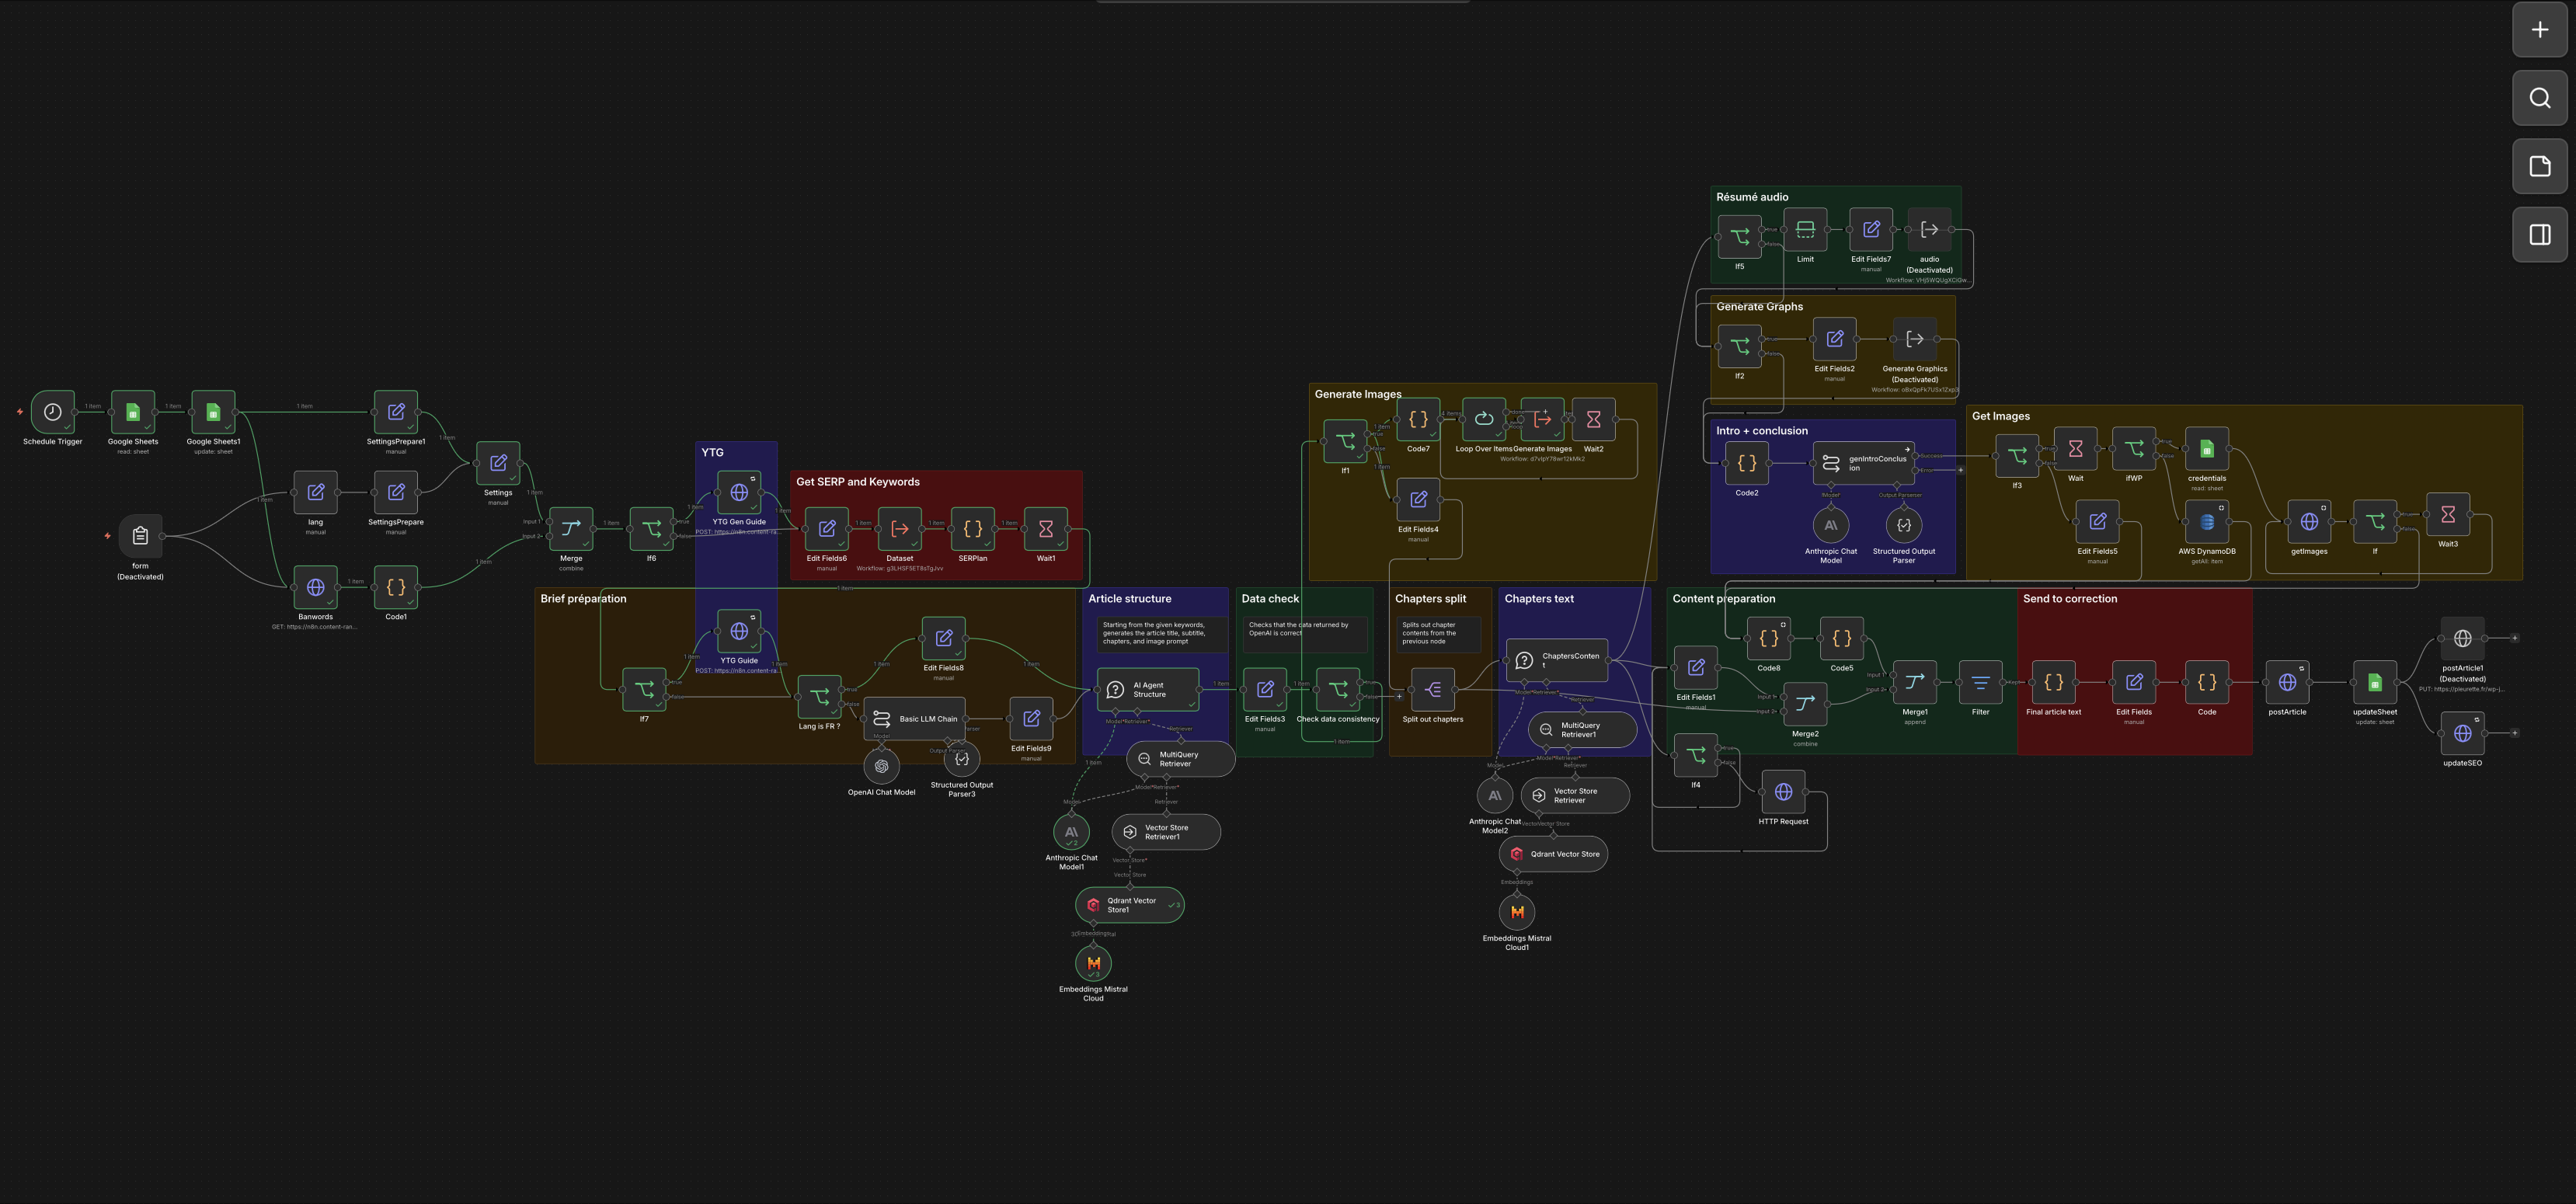
La méthode manuelle que vous venez d'appliquer : c'est exactement celle qui tourne dans nos pipelines n8n. La différence : 3 minutes au lieu de 45.
n8n · Claude · Qdrant · Browserless · AWS S3 · WordPress API
Vous ne formez pas des rédacteurs IA.
Vous formez des directeurs éditoriaux augmentés.
2 jours pour déployer l'IA dans votre production de contenus : méthode, automatisation, pipeline complet.
CRM, facturation, extraction de données, SAV… Tout ce qui pèse sur vos journées peut être automatisé.
Appel découverte →